공공 날씨 API를 매시간 모으기
인증키 없이 쓰는 Open-Meteo 날씨 API에서 서울의 시간별 기온·강수량을 받아, 건수를 확인하고, DuckDB 파일에 저장하는 DAG를 만듭니다. 실무 파이프라인의 기본 모양인 "받기 → 확인 → 저장"입니다.
준비
저장소로 쓸 DuckDB를 Airflow와 같은 가상환경에 설치합니다. 실습에서는 파일 하나로 된 데이터베이스면 충분합니다.
pip install duckdbDAG 파일
seoul_weather.py 하나에 DAG 두 개가 들어 있습니다. 이 장에서는 위쪽 seoul_weather_collect를 보고, 아래쪽 seoul_weather_report는 A06장에서 봅니다.
from datetime import datetime, timedelta
import json
import urllib.request

import duckdb
from airflow.sdk import Asset, dag, task

DB_PATH = "/tmp/airflow_lesson/weather.duckdb"
weather_table = Asset("duckdb://weather/seoul_hourly")

URL = (
    "https://api.open-meteo.com/v1/forecast"
    "?latitude=37.5665&longitude=126.978"
    "&hourly=temperature_2m,precipitation&timezone=Asia%2FSeoul&forecast_days=2"
)


@dag(
    schedule="0 * * * *",               # 매시 정각
    start_date=datetime(2026, 11, 1),
    catchup=False,
    default_args={"retries": 2, "retry_delay": timedelta(minutes=1)},
    tags=["교안"],
)
def seoul_weather_collect():
    @task
    def fetch():
        with urllib.request.urlopen(URL, timeout=20) as r:
            data = json.load(r)
        h = data["hourly"]
        return [
            {"ts": t, "temp": temp, "rain": rain}
            for t, temp, rain in zip(h["time"], h["temperature_2m"], h["precipitation"])
        ]

    @task
    def check(rows):
        if len(rows) < 24:
            raise ValueError(f"받은 행이 {len(rows)}개뿐입니다. 24개 이상이어야 합니다.")
        return rows

    @task(outlets=[weather_table])
    def save(rows):
        import os
        os.makedirs(os.path.dirname(DB_PATH), exist_ok=True)
        con = duckdb.connect(DB_PATH)
        con.execute("CREATE TABLE IF NOT EXISTS seoul_hourly (ts TIMESTAMP PRIMARY KEY, temp DOUBLE, rain DOUBLE)")
        con.executemany(
            "INSERT OR REPLACE INTO seoul_hourly VALUES (?, ?, ?)",
            [(r["ts"], r["temp"], r["rain"]) for r in rows],
        )
        n = con.execute("SELECT count(*) FROM seoul_hourly").fetchone()[0]
        con.close()
        return n

    save(check(fetch()))


@dag(schedule=[weather_table], start_date=datetime(2026, 11, 1), catchup=False, tags=["교안"])
def seoul_weather_report():
    @task
    def summarize():
        con = duckdb.connect(DB_PATH, read_only=True)
        rows = con.execute("""
            SELECT CAST(ts AS DATE) AS day, round(min(temp),1), round(max(temp),1), round(sum(rain),1)
            FROM seoul_hourly GROUP BY 1 ORDER BY 1
        """).fetchall()
        con.close()
        for day, lo, hi, rain in rows:
            print(f"{day} 최저 {lo}도 / 최고 {hi}도 / 강수 {rain}mm")
        return len(rows)

    summarize()


seoul_weather_collect()
seoul_weather_report()
세 태스크가 나눠 맡는 일
fetch: API에서 이틀 치 시간별 데이터를 받아 행 목록으로 바꿉니다. 네트워크 오류는 DAG의 retries가 처리합니다.
check: 24행보다 적으면 일부러 실패시킵니다. 응답 형식이 바뀌었을 때 빈 데이터가 저장되는 것을 막습니다.
save: 시각(ts)을 기본키로 INSERT OR REPLACE합니다. 같은 시각을 여러 번 받아도 중복이 쌓이지 않으니, 재시도나 백필을 해도 결과가 같습니다.
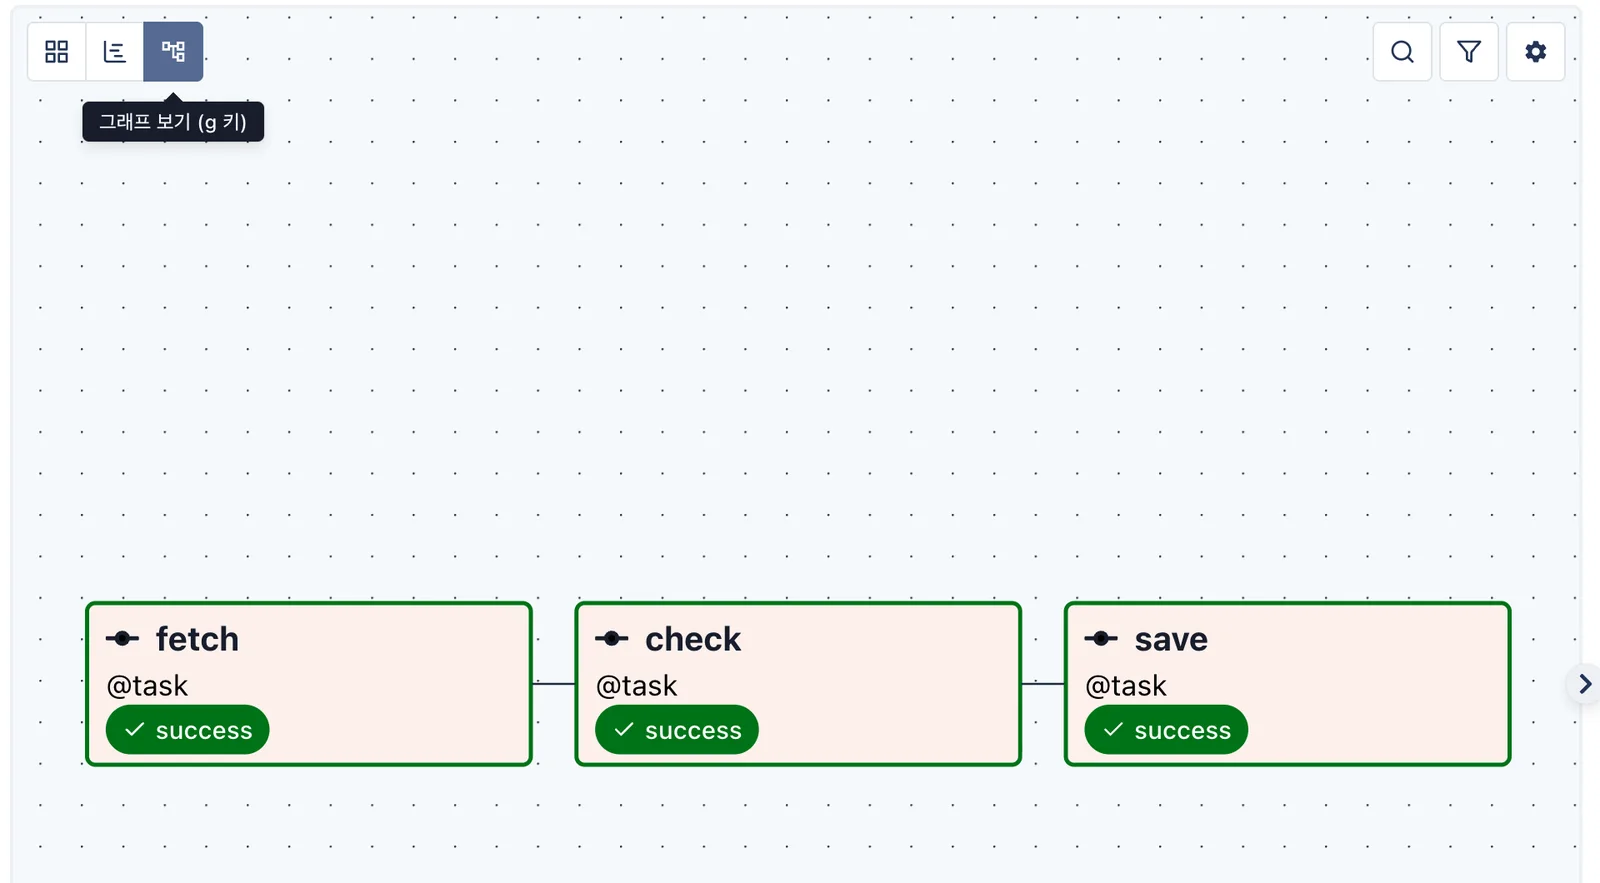
3번이 실무에서 가장 중요합니다. 같은 실행을 두 번 돌려도 결과가 같아야(멱등성) 실패 후 재시도와 백필을 마음 놓고 쓸 수 있습니다. 매번 행을 덧붙이기만 하면 재시도할 때마다 데이터가 두 배가 됩니다.
저장 위치는 실습용입니다. 예제는
/tmp/airflow_lesson/weather.duckdb에 저장합니다. 실제로는 데이터웨어하우스나 오브젝트 스토리지에 쓰고, 접속 정보는 코드에 적지 않고 Airflow의 Connection에 넣습니다.
파이프라인은 받기 → 확인 → 저장으로 나누고, 저장은 몇 번을 다시 돌려도 결과가 같게 만듭니다.